🤖 Préconsulter l’IA — gratuit (الذكاء الاصطناعي — فابور)
TBIBEC.com
Données sécurisées · Consultation 90 DH · Remboursement CNSS
🚀 DSpark – le déclic inattendu▼
DeepSeek vient de sortir un petit framework qui change tout. Leur modèle V4 Pro génère 57 à 78 % plus vite sans perte de qualité et sans toucher aux poids. Ça s’appelle DSpark.
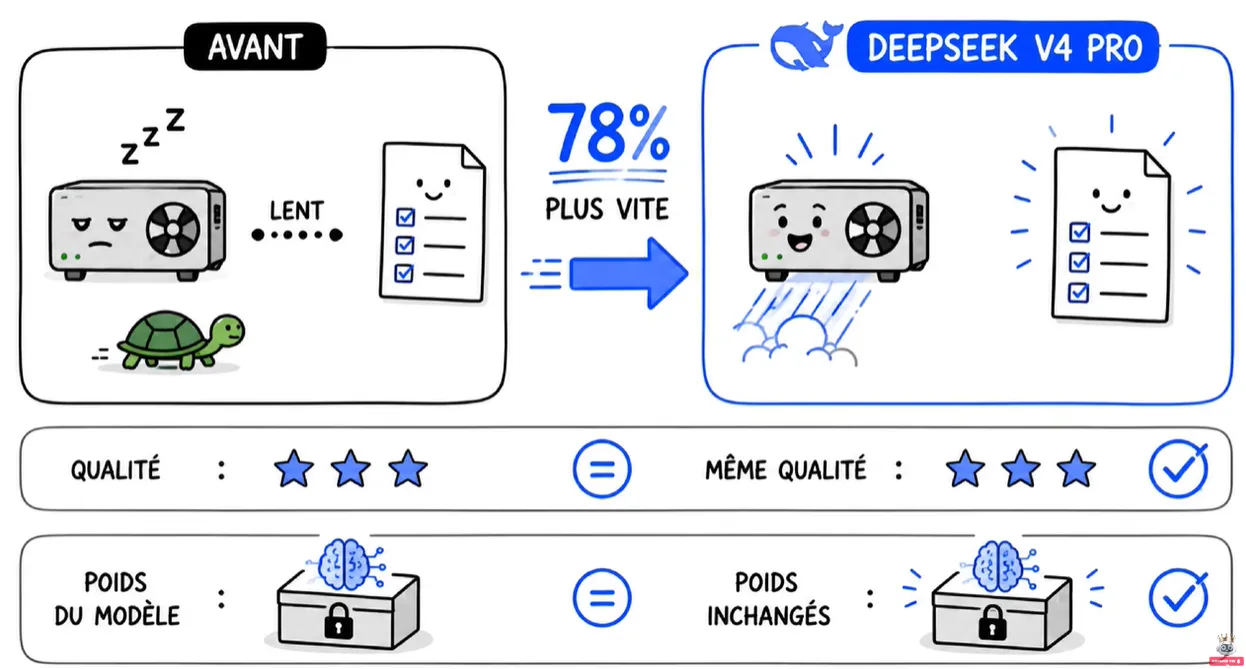
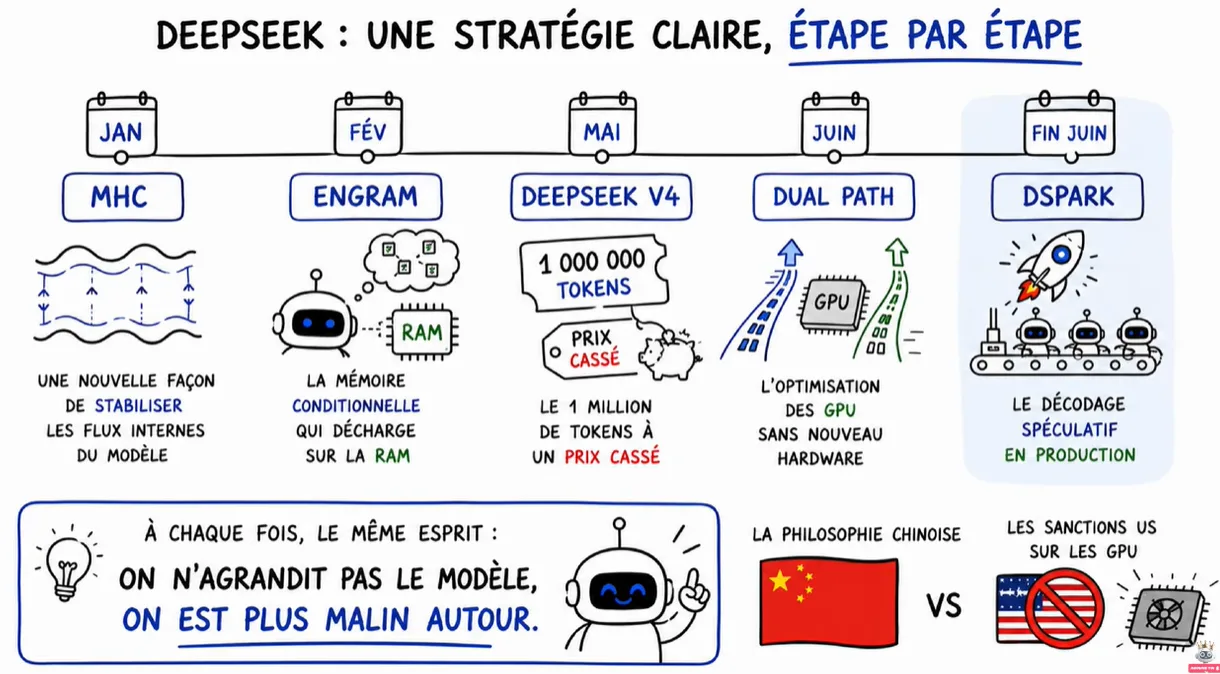
C’est la 5e fois en 6 mois que DeepSeek optimise au lieu d’agrandir. La philosophie : on n’agrandit pas le modèle, on le rend plus malin. C’est la stratégie chinoise face aux sanctions américaines sur les GPU.
🔄 Pourquoi les LLM sont lents de base▼
Quand tu envoies une question à un LLM, il génère la réponse un mot à la fois. C’est la génération autorégressive.
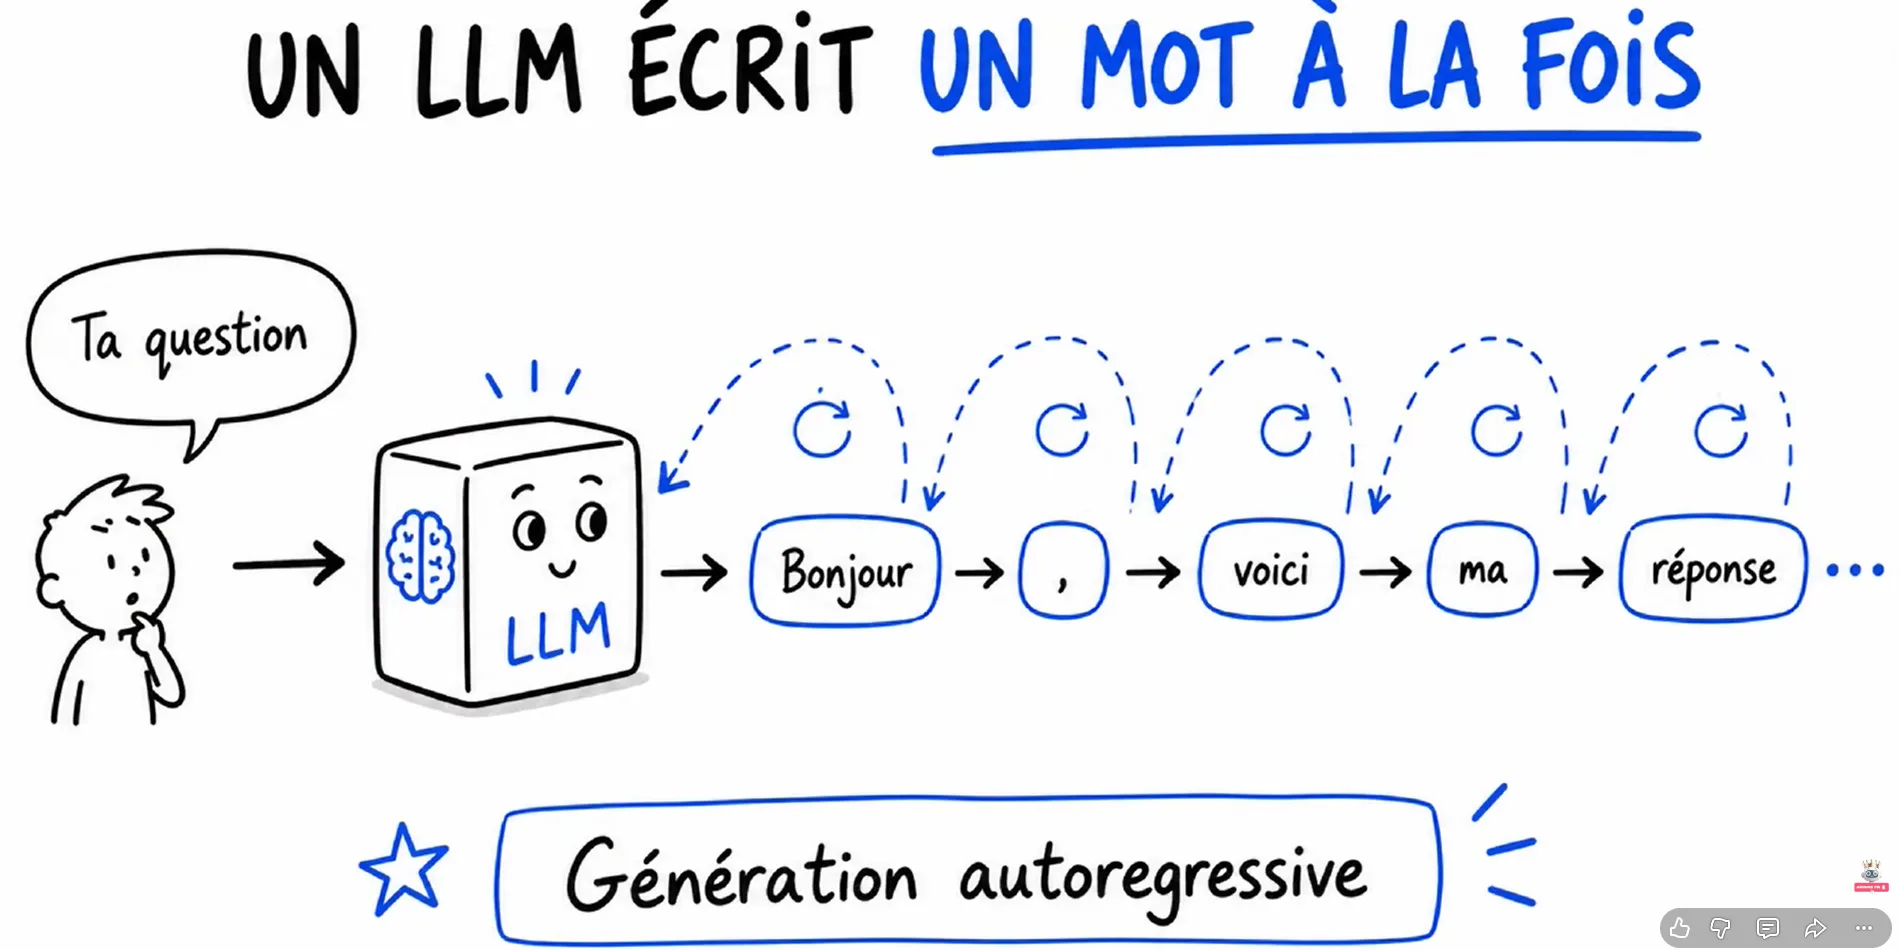
Pour chaque nouveau mot, le modèle doit relire toute sa mémoire interne (le KV cache).
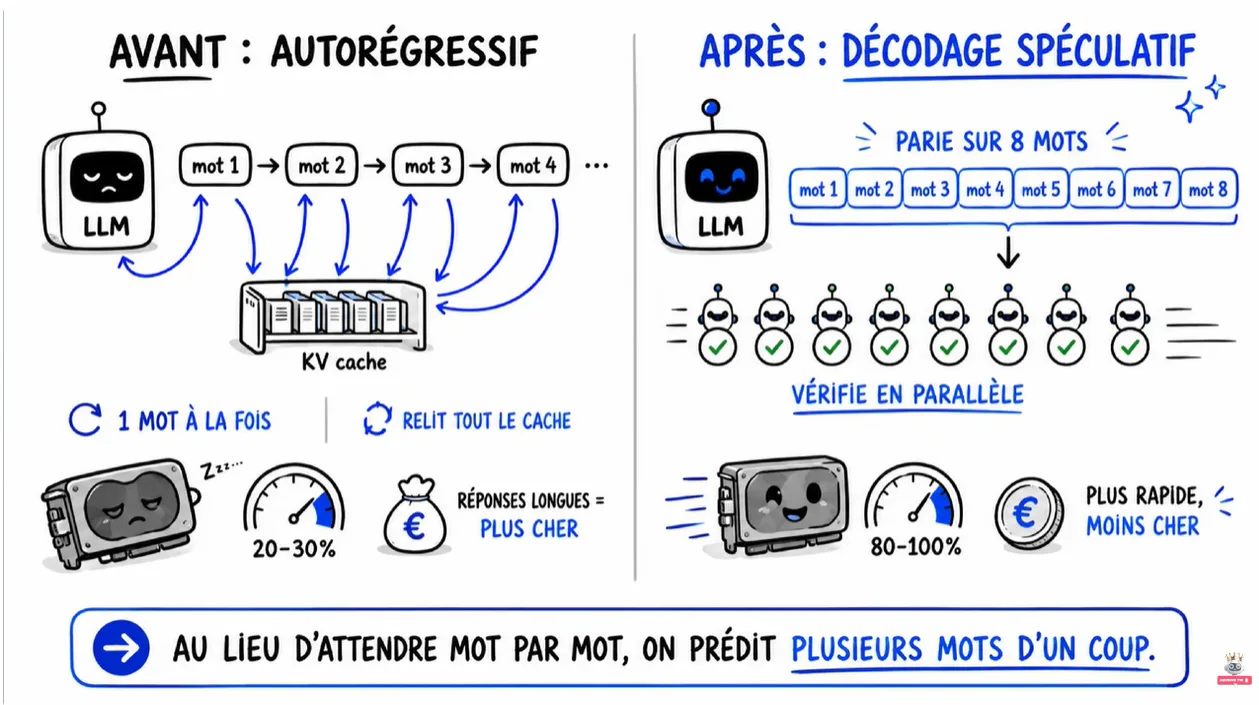
Le décode représente 95 % du temps d’une requête. Pour 300 tokens, c’est 20 ms de préfil contre 9 s de décode.
🧠 Le décodage spéculatif – le petit propose, le gros vérifie▼
Le décodage spéculatif existe depuis un moment. Le principe est presque trop simple pour être vrai.
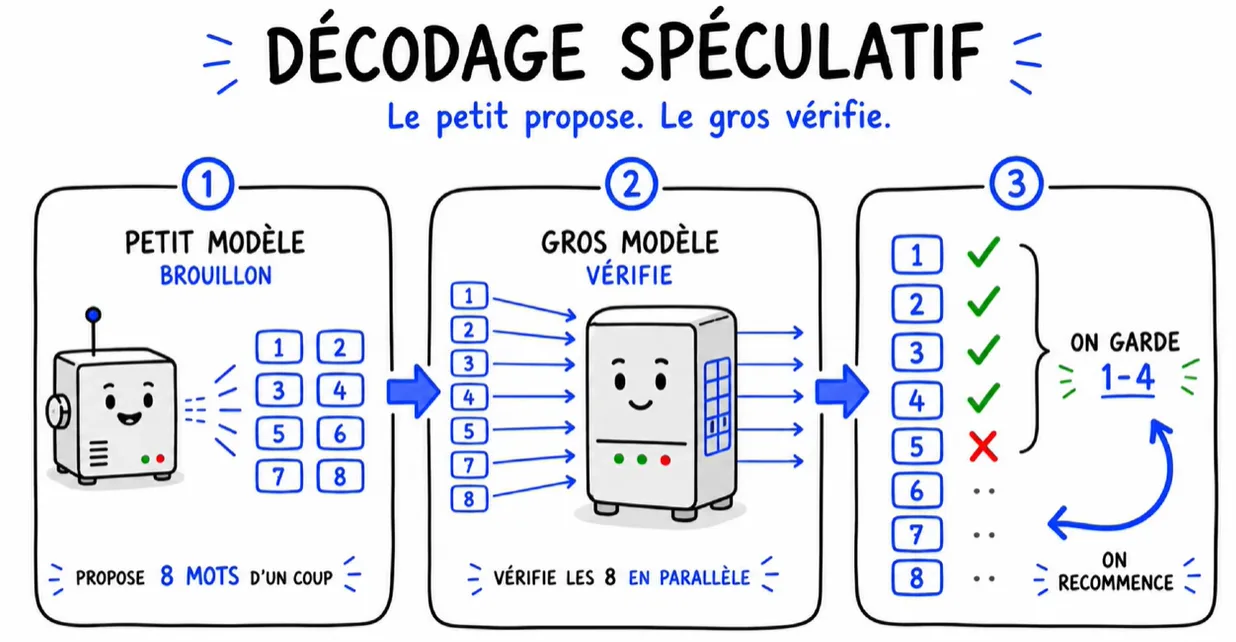
- Un gros ultra-puissant – modèle cible.
- Un petit modèle rapide – modèle brouillon.
Le petit propose une rafale de mots (ex. 8 d’un coup). Le gros vérifie les 8 propositions en une seule passe parallèle. Si ça valide, tu as généré 8 mots pour le prix d’un.
⚖️ Deux approches, deux problèmes▼
Le problème historique : personne n’avait encore la vitesse ET la cohérence.
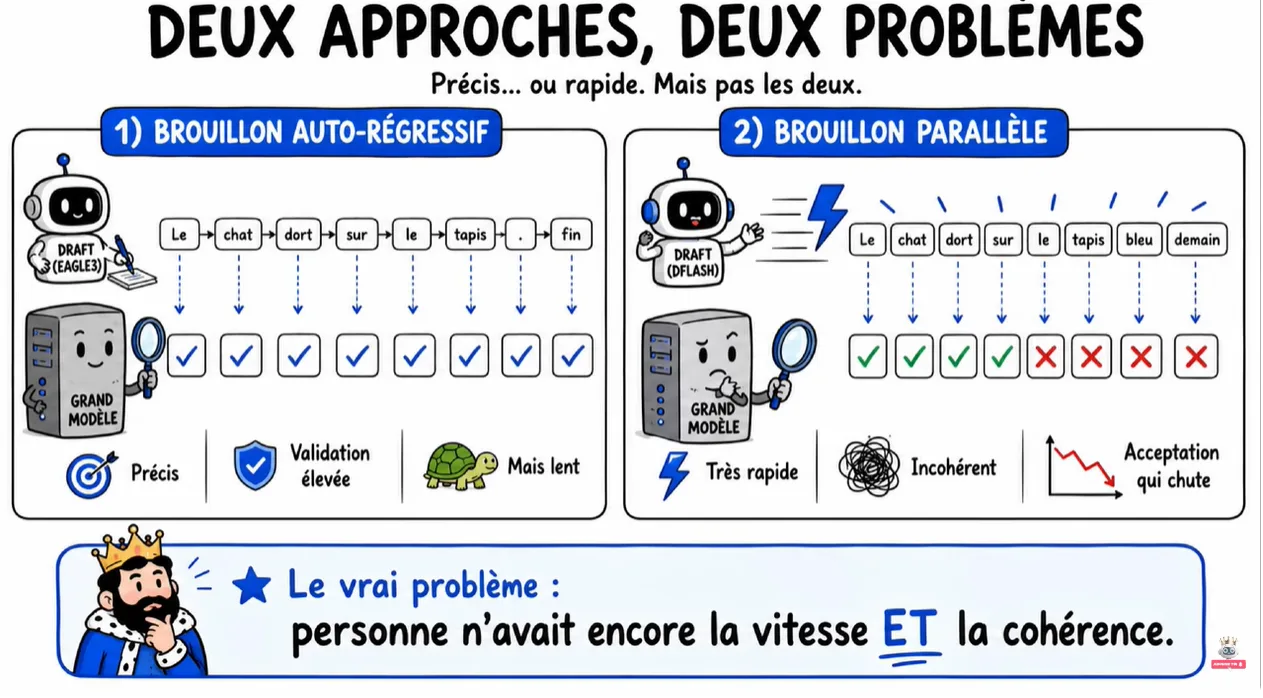
- Approche autorégressive (Eagle3) : précise, mais le brouillon prend du temps.
- Approche parallèle (DFlash) : ultra-rapide, mais incohérence → taux d’acceptation qui s’effondre.
🔗 La tête de Markov – le brouillon devient plus malin▼
DeepSeek ajoute une idée maline : la tête de Markov. Une mini couche avant le choix final des mots.
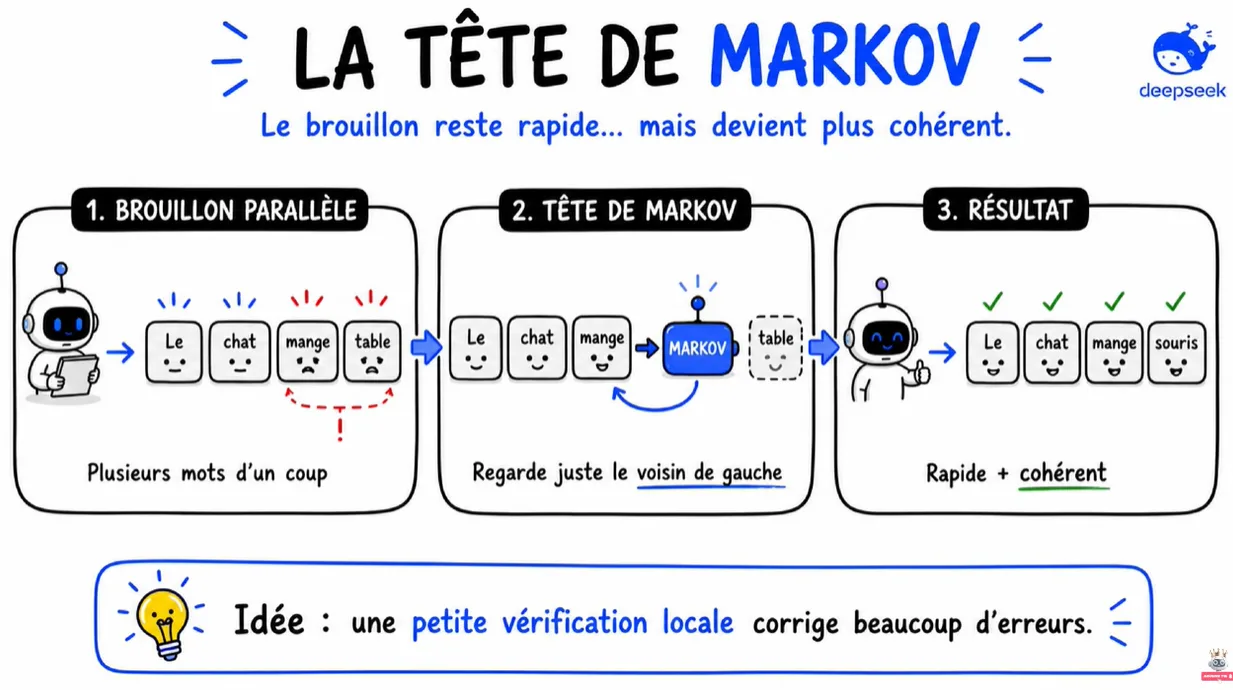
Elle regarde seulement le mot juste avant. Pas toute la phrase, juste le voisin de gauche.
📊 Vérifier plus intelligemment▼
Le deuxième problème : vérifier 16 mots pour n’en garder que 6. C’est du calcul gaspillé.
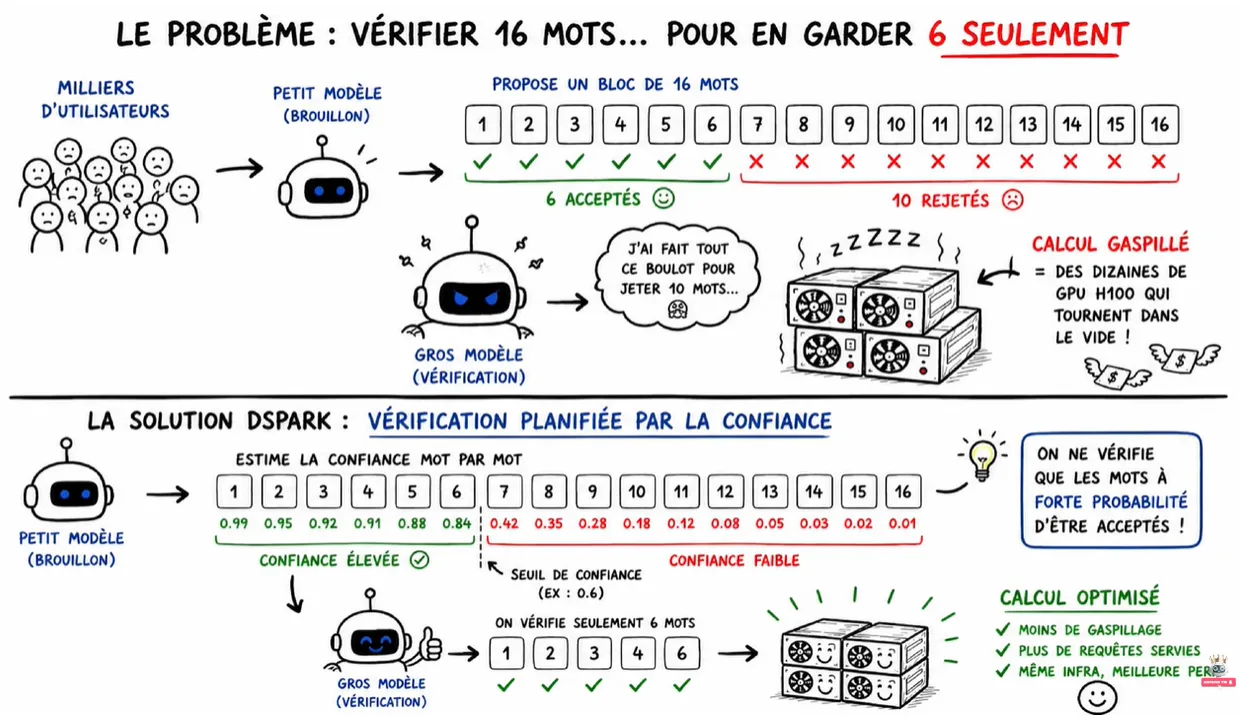
La solution de DSpark : la vérification planifiée par la confiance.
- Tête de confiance : un score pour chaque mot du brouillon.
- Recalibrage : Sequential Temperature Scaling (STS) – erreur de calibration passe de 3-8 % à ~1 %.
- Vérification adaptative : la taille du bloc s’adapte à la charge GPU.
📈 Performances en production – des chiffres explosés▼
Les résultats sont impressionnants. Voici les chiffres en production réelle sur les serveurs de DeepSeek.
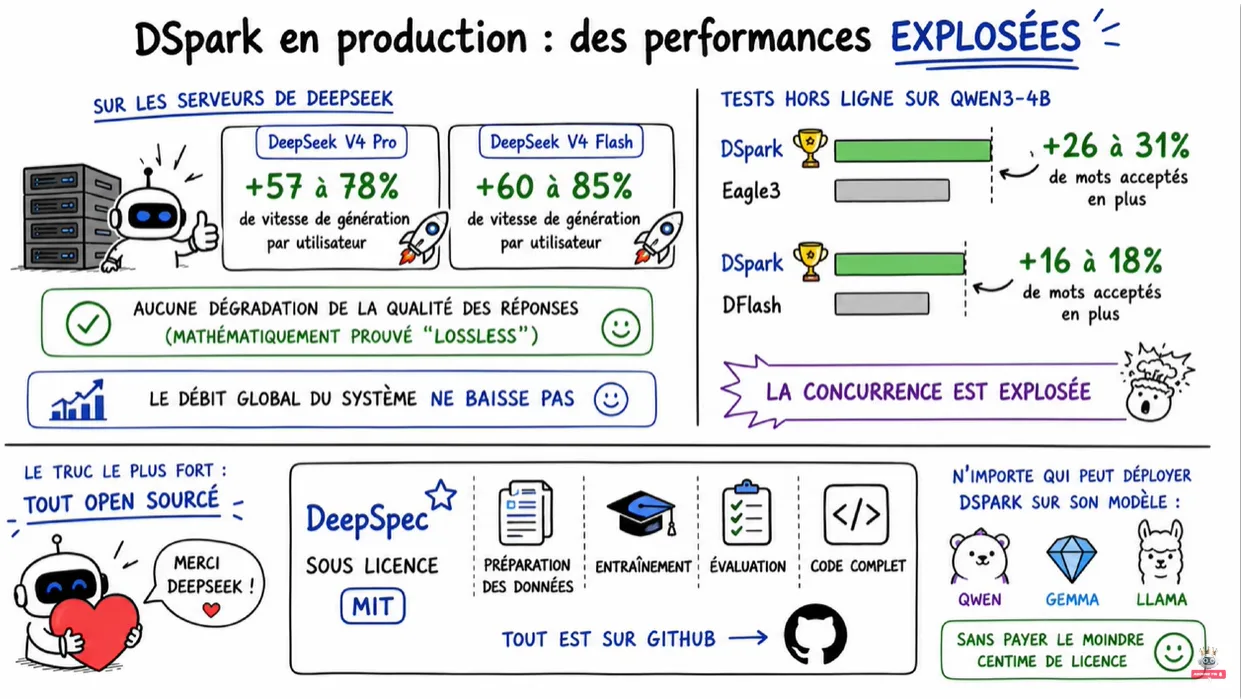
- DeepSeek V4 Pro : +57 à 78 % de vitesse.
- DeepSeek V4 Flash : +60 à 85 %.
- Aucune dégradation de la qualité (prouvé “lossless”).
- Sur Qwen 3-4B, DSpark accepte 26 à 31 % de mots en plus que Eagle3.
🔓 DeepSeek open source – DeepSpec▼
DeepSeek a tout open sourcé sous licence MIT.
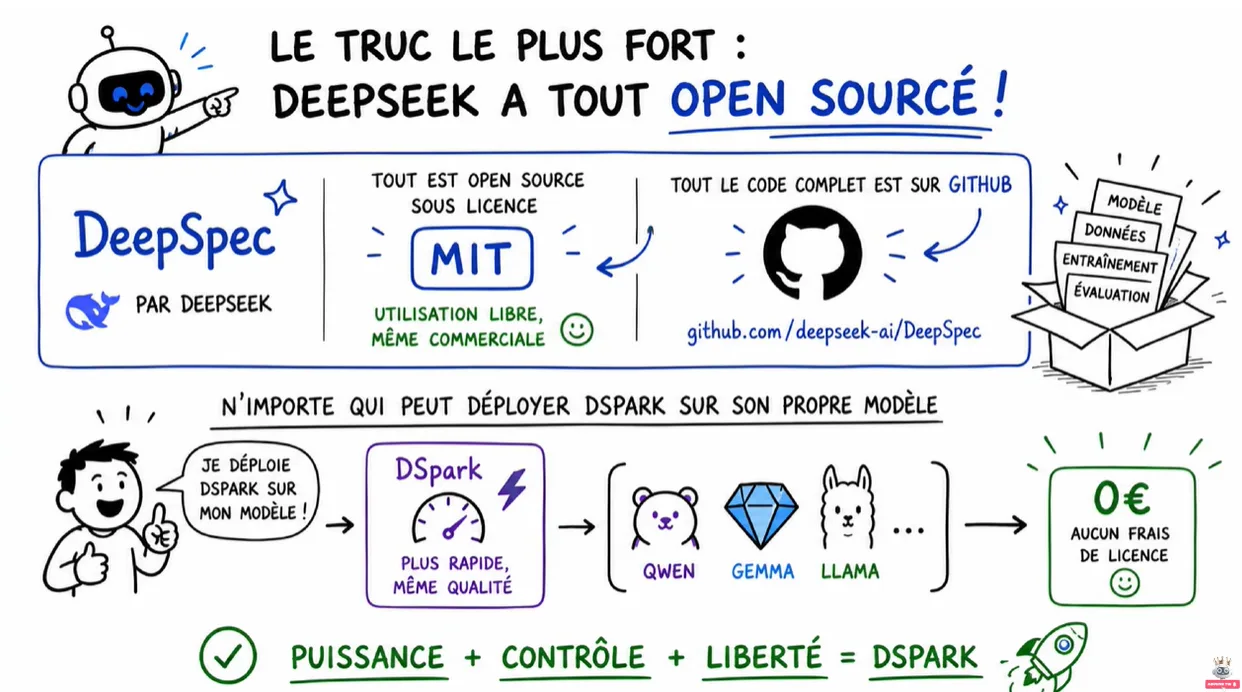
- MIT : utilisation libre, même commerciale.
- Code complet : préparation des données, entraînement, évaluation.
- Compatible Qwen, Gemma, Llama.
🧭 La stratégie DeepSeek – étape par étape▼
En 6 mois, DeepSeek a enchaîné les innovations. Toujours le même esprit : on n’agrandit pas le modèle, on est plus malin autour.
⚠️ Les angles morts de DeepSeek V4 Pro▼
Soyons honnêtes : DeepSeek V4 Pro a deux angles morts qu’il faut connaître.
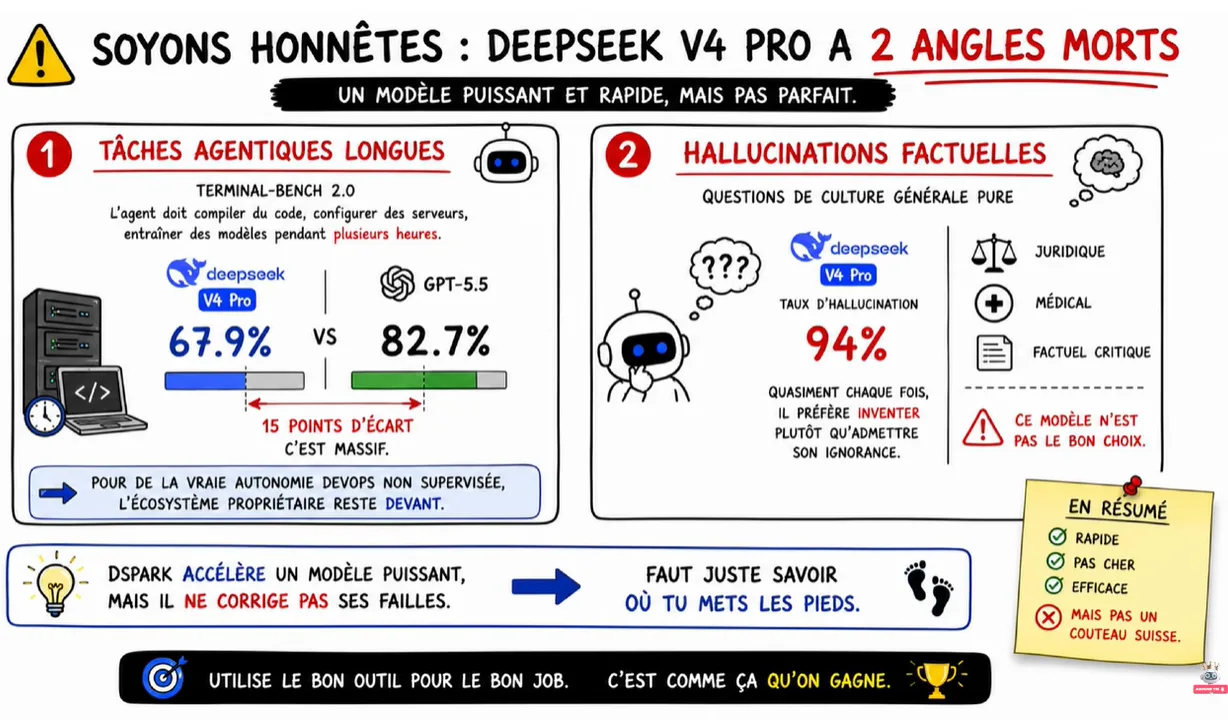
1. Tâches agentiques longues
- DeepSeek V4 Pro : 67,9 %
- GPT-5.5 : 82,7 % → 15 points d’écart.
2. Hallucinations factuelles
- DeepSeek V4 Pro : 94 % de taux d’hallucination.
- Il préfère inventer plutôt qu’admettre son ignorance.
🌍 Le marché de l’IA se divise▼
Pendant que tout le monde regarde les modèles propriétaires, DeepSeek joue un autre jeu.
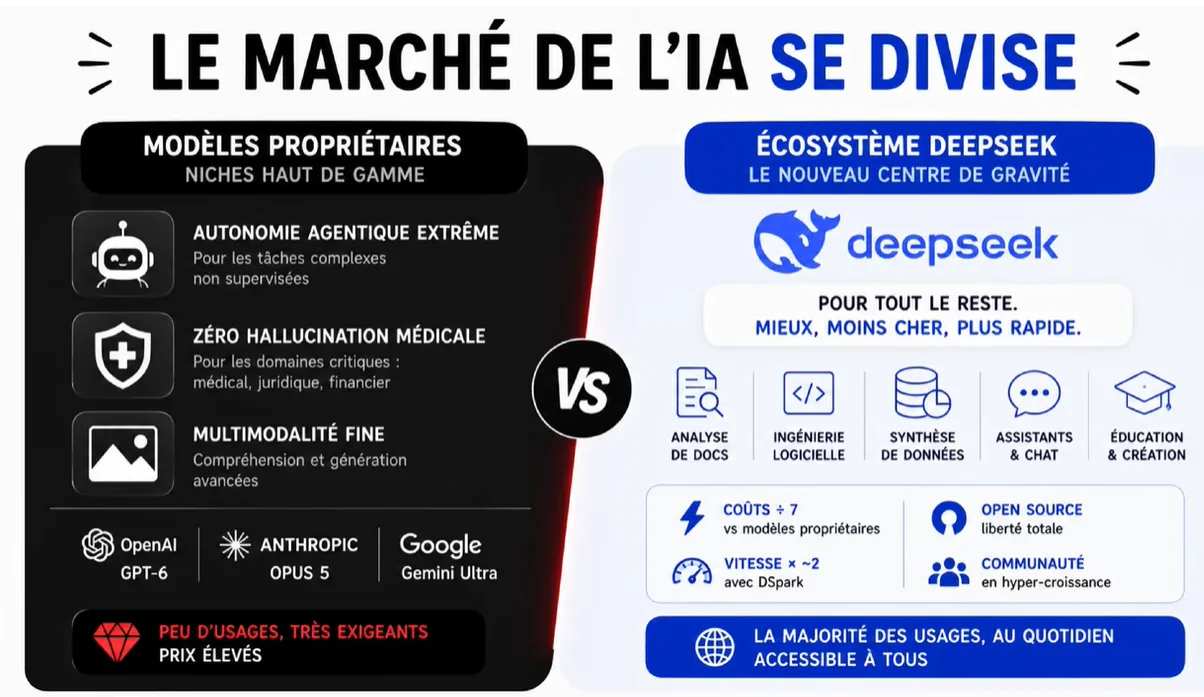
- Modèles propriétaires : autonomie agentique extrême, zéro hallucination médicale. Prix élevés.
- Écosystème DeepSeek : pour tout le reste – mieux, moins cher, plus rapide. Coûts ÷7, vitesse ×2 avec DSpark.
👁️ Pendant que tout le monde regarde ailleurs, DeepSeek joue un autre jeu▼
Pas de blabla. Juste des résultats.
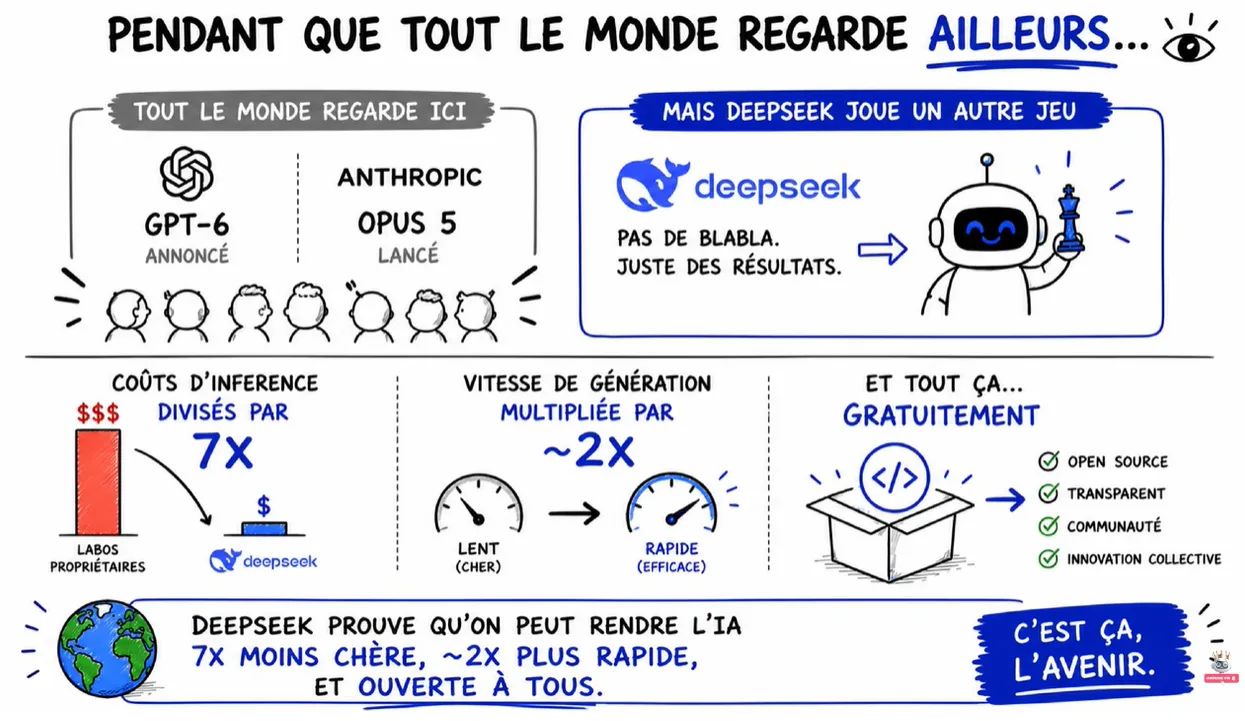
- Coûts d’inférence : divisés par 7.
- Vitesse de génération : multipliée par ~2.
- Et tout ça : gratuitement, open source, transparent.
🤖 Envie d’explorer l’IA médicale ?
Testez gratuitement notre module IA pour décrire vos symptômes ou analyser une image.
🩺 Accéder à l’IA médicale© 2025 TBIBEC.com • Consultation 90 DH · Remboursement CNSS
Résumé de cette page en français, en arabe et en tamazight
En résumé (français)
Cette page présente DSpark, un nouveau framework de DeepSeek qui accélère la génération des réponses des modèles d'IA de 57 à 85 % sans perte de qualité, grâce à une technique appelée décodage spéculatif. DeepSeek a rendu ce code open source sous licence MIT, ce qui signifie que tout le monde peut l'utiliser, y compris à des fins commerciales. À noter que ces modèles restent imparfaits : ils peuvent encore produire des erreurs ou des informations inventées, et DSpark ne corrige pas ces limites. Pour vos questions de santé, notre module d'IA médicale reste disponible gratuitement sur mondoclib.com, et vous pouvez aussi prendre rendez-vous au cabinet du TBIBEC.com (TBIBEC.com) au 05 37 27 20 20, avec remboursement CNSS.
خلاصة بالعربية
يقدّم موقع mondoclib.com خدمة الذكاء الاصطناعي الطبي مع إمكانية الحجز الفوري لدى طبيبكم على الرقم 05 37 27 20 20. يمكن للمريض وصف الأعراض أو إضافة صورة، فتُحلَّل الحالة وتُترجم إلى الفرنسية قبل الاستشارة. كما تتوفر خدمة التطبيب عن بُعد بتكلفة إجمالية 90 درهماً، مع ضمان سرية المعطيات.
Tamazight (lettres latines)
G mondoclib.com tlla twuri n taẓṛigt tamussnawt d usitn uzrif ɣr TBIBEC.com s 05 37 27 20 20. Tzddart ad tarut imukrisn nɣ tawlaft, ttuslɛlnt tumayin ussin s tfṛansist ur tawḍ tsmunt. Talla taẓṛigt s untirnt s 90 drhm s umzwaru.